

Linux 运维选机器:先看 ECC 内存
接手一台服务器之前,多数运维会先问 CPU 几核、内存多大、带宽多少。这三项问完,单子基本就定了。但真正让人半夜爬起来排查的,往往不是算力不够,而是机器给出的结果不可信:编译莫名其妙失败,数据库偶尔返回一条不该存在的数据,日志里翻不出任何线索。Linus Torvalds 在 2022年就撞上过这种事,内核构建任务随机冒出内部编译器错误,看着像软件 Bug,最后查出来是一根已经损坏的 DIMM。
报错指向软件时,先看 EDAC 里的可纠正错误计数
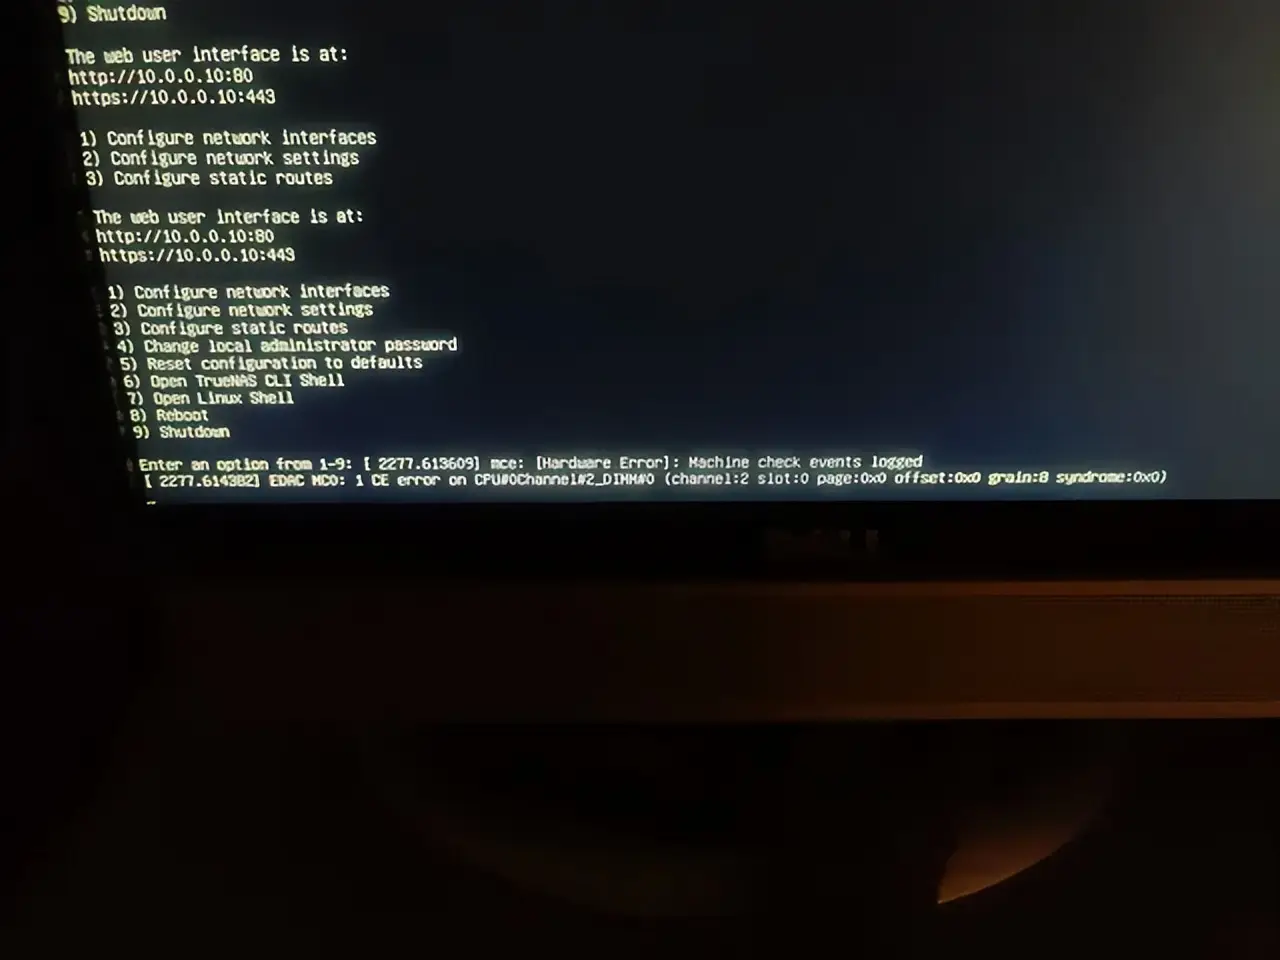
内存出错不是理论上的极端情况。DRAM 会受硬件老化、电气干扰和制造缺陷影响,某个比特从 0 翻成 1,系统自己不会知道。普通内存按 64 位数据宽度传输,典型 ECC 内存用 72 位,多出来的 8 位专门存校验数据;SEC-DED 机制能纠正单比特错误,同时检测双比特错误。Linux 内核里的 EDAC 子系统就是干这个的,专门检测和报告内存的可纠正错误与不可纠正错误。
这套机制的价值在排查链条上体现得最清楚。一个比特出错,可能表现为程序异常退出,也可能让数据库写进一条错误数据,还可能让使用者把锅甩给操作系统或者应用代码。CPU、编译器、驱动、文件系统挨个怀疑一遍,成本远高于一根 ECC 内存条的差价。实操上先看机器的 EDAC 日志:可纠正错误计数持续上涨就是明确的更换信号,比等到不可纠正错误把进程打挂要主动得多。对天天编译内核或者跑数据库的机器,这个提前量就是可用性。
租物理机时,ECC 与线路是两条独立的判断线
放到租用场景,选型顺序是先确认这台机器跑什么负载,再定内存要不要 ECC,最后才比 CPU 主频和带宽。跑数据库、虚拟化、编译环境或者对外服务的机器,ECC 属于底线配置;纯做静态页面分发、跑轻量代理的机器,这笔钱可以省下来换带宽。取舍很直接:省下 ECC 的预算,换回的是更高的单比特错误风险,以及一次难以复现的故障排查。线路和硬件不能互相替代——带宽再足,也补不上内存翻转带来的数据错误。
以香港机房为例,香港自营国际物理服务器 是 E3-1230 V2、16G、100M 带宽、月付 ¥750.00 这一档,适合中小规模业务先把机器跑起来;如果业务对出口带宽要求更高,香港大带宽服务器 XV 给到 Platinum-8168*2、64G、G 口,月付 $358.50,内存容量上去了,跑多实例和缓存的余地也更大。两档的差别在带宽与内存容量,而 ECC 是否可用、EDAC 能否读到计数,需要在下单前向服务商确认到具体机型,这比多要 2 核更有实际意义。
开发节奏加快,只会放大底层不可信的成本
2026年 11 月 9 日,Torvalds 在 7.4-rc2 的更新说明里提到,AI 辅助修复已经推动了相当一部分内核代码变更,BPF 子系统甚至出现 AI 提供的修复数量超过新增问题报告的情况。同月,CentOS 创始人之一 Gregory Kurtzer 用 11 天、约 13.9 万行 Rust 代码做出兼容 Linux ABI 的 Ginux,能启动 Rocky Linux 10 并跑到 systemd,单核 2GiB 下登录耗时 12.9 秒。但 Kurtzer 自己也说,兼容性、硬件支持、标准和长期维护才是真正的护城河。
对运维来说,结论不是去追新内核,而是机器底层的可信度变得更值钱。代码更新越频繁,编译和回归测试的频次越高,内存出错被误判成代码问题的概率就越大——Torvalds 那次误判的排查路径,会在更短的迭代周期里被重复更多次。
Linux这类判断之前也写过几篇,取舍逻辑可以对照着看,选 Linux 发行版别只看教程多不多,先看你打算折腾几年、选错发行版比选错硬件更贵:Linux 运维选型的四笔隐性账。Linux服务器买之前先想清楚:你要的是机器,还是三年后还在跑的机器讲的角度不太一样,两篇一起看更清楚。